Kontextschicht für KI-Agenten: belegte Antworten und freigegebene Aktionen über Chat, Tickets, Wiki und CRM
Ihr Team sucht den aktuellen Kundenstand in Chats, Tickets und CRM und muss trotzdem Kollegen fragen, was wirklich beschlossen wurde. Ich baue Kontextschichten für KI-Agenten, die diese Informationen verbinden: wie ein gemeinsames Übergabebuch mit Quellen und Zeitangaben. Berechtigte Kollegen können Entscheidungen nachvollziehen, auch wenn sie beim Meeting fehlten. Aktionen in anderen Systemen brauchen eine Freigabe.
Problem: Das Unternehmen hatte nicht einen aktuellen Stand je Kunde. Es hatte fünf: das Ticket-Board, die Wiki-Seite, den Chat-Thread, den CRM-Deal und das Meeting, das alle vier überstimmt hat. Zu wissen, was sich bewegt hat, hieß sechs Systeme prüfen, oder es zwei Tage später im Meeting hören.
Lösung: Eine kontrollierte Schicht auf dem eigenen Cloud-Tenant des Unternehmens. Sie liest jede Quelle als die fragende Person, faltet die Änderungen pro Kunde, zitiert die Textstelle hinter jedem Eintrag und lässt eine benannte Person jede Aktion freigeben, bevor etwas geschrieben wird. Das Teilen läuft automatisch: eine Person schaltet es einmal ein, und jeder freigegebene Fakt aus ihren Meetings erreicht innerhalb von Minuten die Teams, die er betrifft, ohne einen Handgriff pro Meeting.
Geschäftswert: Wissen aus einem Meeting oder Telefonat wird als gezeichneter Fakt mit genau dem Team geteilt, das es betrifft. Wer nicht im Meeting war, erfährt, was entschieden wurde, ohne jemanden zu fragen, der dabei war. Ein Änderungsradar ersetzt sechs Morgenkontrollen. Jeder Schreibzugriff in Tickets, Wiki oder Chat ist einer, den eine Person freigegeben hat, mit Beleg auf der Karte, sodass ein Audit die Entscheidung liest, nicht ein Log.
Rahmen: Zuerst ein Architektur-Review des Schreibpfads eurer Agenten mit festem Stundenumfang, dann ein phasenweiser Aufbau im eigenen Tenant, nach Stunden abgerechnet. Compute, Speicher und Modell-Inferenz in der EU.
Transkript des Videos lesen
Das Pulse-Dashboard zeigt relevante Änderungen. Quelle und Begründung stehen an jedem Eintrag.
Die Action Inbox trennt Entscheidungen von ausführbaren Aufgaben und dokumentiert jedes Ergebnis.
Im Vorschlagsbereich werden Aussagen aus Meetings geprüft. Die verantwortliche Person legt den Leserkreis fest und bestätigt den Fakt.
Eine Notiz kann mehrere Themen enthalten. Beim Mapping erhält jeder Fakt die passende Verbindung zu einem Kunden, Produkt oder Regelwerk. Unklare Treffer bleiben offen.
Nach der Freigabe ist ein Fakt automatisch für das berechtigte Team sichtbar. Bei persönlichen Quellen wird das Teilen weiterhin manuell freigegeben.
Dieser kontrollierte Ablauf führt von der Änderung zur Aktion und zum Wissen im Team. Im ersten Architekturtermin bilden wir den Ablauf gemeinsam ab.
Das Problem
Ein B2B-Technologieunternehmen in DACH führt Enterprise-Kundenprojekte über Vertrieb, Delivery und Engineering. Jeder Kunde lebt an sechs Orten gleichzeitig: ein Ticket-Board, ein Wiki-Bereich, ein Chat-Kanal, ein CRM-Deal, mehrere Postfächer und die Meetings, in denen die eigentlichen Entscheidungen fallen. Stakeholder aus Vertrieb, Delivery, Engineering, Betrieb und Management wurden befragt, bevor die erste Zeile Code entstand. Ihre Fragen, verdichtet:
- Welcher der fünf Stände dieses Kunden ist aktuell, und wer hat das entschieden?
- Was hat sich seit meinem letzten Blick bewegt, das ich vermutlich verpasst habe?
- Kann ich einer Antwort trauen, oder muss ich die Quelle ohnehin öffnen?
- Kann das System auf eine Änderung hin handeln, und wer trägt die Verantwortung, wenn es das tut?
- Was darf ein Kollege von meinen Meetings und meinen Deals sehen, und was darf ein Assistent sehen?
- Übersteht das einen Security-Review?
Digests gab es bereits. Die Chat-Suite fasst Nachrichten und Mails pro Person zusammen, die Wiki-Suite fasst Seiten und Tickets pro Person zusammen. Keins von beiden zitiert die Textstelle, die einen Eintrag vor dich gelegt hat, keins trägt die Unterschrift eines Kollegen, keins schreibt in den Datensatz zurück, und keins weiß, zu welchem Kunden eine Seite, ein Thread und ein Ticket gehören. Diese Lücke ist der ganze Auftrag.
Diese Fallstudie richtet sich an CTOs, VPs Engineering und IT-Leitungen in DACH-Unternehmen, die eine Kontextschicht für ihre KI-Agenten brauchen: belegte Antworten und freigegebene Aktionen über Chat, Tickets, Wiki und CRM auf dem eigenen EU-Cloud-Tenant, auf einem temporalen Wissensgraphen, der jeden Fakt mit Quelle und Gültigkeitszeitraum hält. Das Angebot dahinter ist die Knowledge-Graph-Beratung.
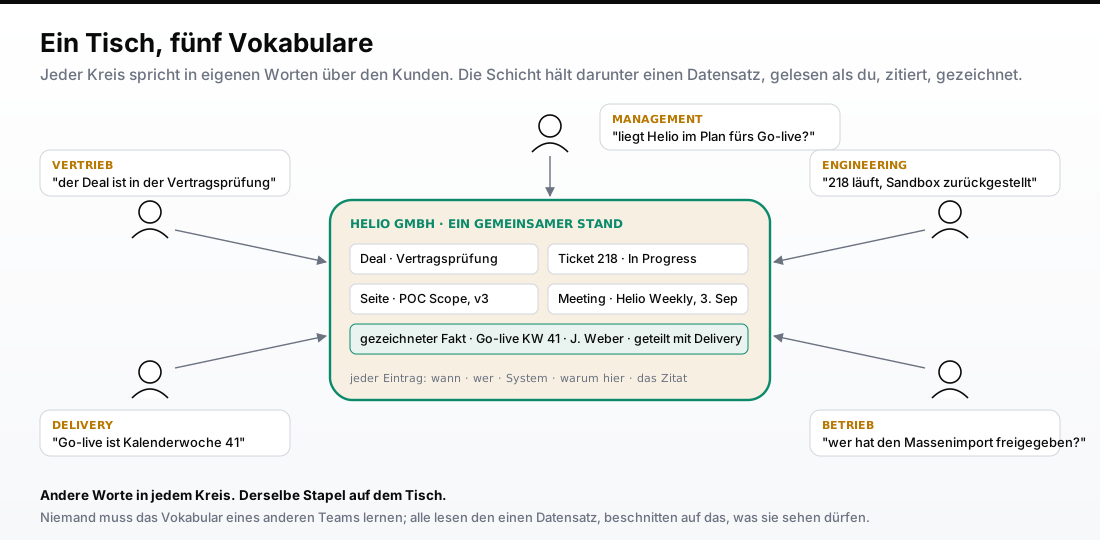
Ein Tisch, fünf Vokabulare. Jeder Kreis spricht in eigenen Worten über den Kunden; die Schicht hält darunter einen Datensatz, gelesen als du, zitiert, gezeichnet.
Die Lösung
Eine operative Kontextschicht im eigenen Tenant des Unternehmens. Sie löst die drei Dinge, die jede Plattform für operative Intelligenz lösen muss, und bleibt dabei klein: typisierte Datensätze, delegierte Lesezugriffe und menschliche Autorisierung vor externen Aktionen.
Eine operative Kontextschicht (englisch: operational context layer) ist eine berechtigungsbewusste Schicht über den Systemen eines Unternehmens (Chat, Tickets, Wiki, CRM, Postfach, Meeting-Notizen), die entscheidet, welcher Eintrag aktuell ist und für wen, die Textstelle hinter jedem Eintrag zitiert und daraus eine Aktion macht, die eine benannte Person freigibt.
1. Ein Modell des Geschäfts
- Ein Kundenregister, unter das alles fällt. Eine Seite, ein Thread, ein Ticket, ein Deal und ein Meeting gehören alle zu einem Kunden, und die Schicht weiß, zu welchem. Das ist die Frage, die kein einzelnes System beantwortet, und das Erste, was das Modell klärt.
- Jeder Datensatz ist typisiert und trägt seine Herkunft. System, Datensatz, Autor, Datum und die zitierte Textstelle reisen mit.
- Fakten als Beziehungen, pro Zeile belegt. Eine Aussage kommt nur als Beziehung in den Graphen, die die Prüfung nachvollziehen kann (Kunde, Go-live, Kalenderwoche 41), von einer Person gezeichnet, mit dem Datensatz, aus dem sie stammt.
2. Kontext, der weiß, wer fragt
- Lesen als du. Die Schicht hat keine eigenen Berechtigungen. Jeder Lesezugriff auf Chat, Postfach, Meeting-Transkripte, Tickets, Wiki und CRM läuft delegiert, als angemeldete Person, und die Gruppenzugehörigkeit kommt zum Zeitpunkt der Frage aus den eigenen Verzeichnisgruppen des Unternehmens.
- Beschnitten, zitiert, oder nicht gezeigt. Eine Antwort wird auf das gekürzt, was die fragende Person sehen darf, jeder Eintrag zitiert die Textstelle dahinter, und ein Treffer, den sie nicht öffnen darf, fällt ohne Zähler weg.
- Automatisch geteilt, mit Zustimmung, pro Zielgruppe. Eine Person schaltet das Teilen einmal ein; von da an erreicht jeder freigegebene Fakt aus ihren Meetings innerhalb von Minuten das Team, das er betrifft, und sonst niemanden, ohne einen Handgriff pro Meeting. Die Kette darunter sagt, wo nachzusehen ist, nie, wie sehr einem Kollegen zu glauben ist.
3. Aktionen, die eine Person verantwortet
- Der Proposals-Tab ist die Aktions-Inbox. Jeder vorgeschlagene Fakt und jede vorgeschlagene Aktion wartet dort auf das Urteil der Person, eine Zeile nach der anderen, als Karte im Chat gepostet. Eine Prüfung bleibt offen, bis eine Person entscheidet; eine verlorene Karte oder eine übersehene Nachricht schließt keine.
- Handeln, wo die Änderung liegt, als du selbst. Ein Kommentar am Ticket, ein Anhang an die Wiki-Seite, eine Antwort in den Chat-Thread, ein Arbeitselement auf dem Board. Der Beleg bleibt auf der Karte.
- Ein Backend, jede Tür. Chat-Bot und Tabs für Menschen; eine MCP-Tür, die dasselbe kontrollierte Backend in Claude (Cowork, Desktop und den claude.ai-Connector), Codex und jede MCP-fähige Anwendung einhängt. Dieselben Speicher, dasselbe Gate, dieselben Audit-Ereignisse, damit Nutzung pro Tür ab Tag 1 messbar ist.
"Sandbox zurückgestellt, bis Helio das Go-live-Fenster bestätigt"
Synthetischer Screenshot 1: das Änderungsradar, mit fiktiven Kunden, Personen und Datensätzen. Jeder Eintrag sagt wann, wer, welches System, warum er auf deinem Radar ist, und zitiert die Erwähnung. Der gezeichnete Fakt trägt seine Kette: erst die zeichnende Person, dann das Meeting, aus dem er stammt, mit wem er geteilt ist, wie viele unabhängige Quellen ihn stützen.
Was die Person sieht
Die Screenshots auf dieser Seite sind synthetisch. Sie zeigen die echten Bildschirme mit fiktiven Kunden, Personen und Datensätzen, damit der Kunde ungenannt bleibt und kein Datensatz den Tenant verlässt.
Fähigkeiten
Wofür die Leute es nutzen, in der Reihenfolge, in der sie es übernommen haben:
- Das Änderungsradar. Was hat sich seit meinem letzten Blick bewegt, das mich betrifft, gefaltet pro Kunde, mit zitierter Erwähnung oder weggelassenem Eintrag. Mindestens ein Tag, höchstens sieben, damit Abwesenheit nachgeholt und nicht stumm verworfen wird. Eine Quelle, die nicht geantwortet hat, steht namentlich auf der Seite, damit ein ruhiges Radar und ein gescheiterter Lesezugriff zwei verschiedene Dinge sind.
- Das Morgen-Briefing. Dasselbe Radar als kurzer Text zum Tagesbeginn, der einen Fakt als Neuigkeit zählt, wenn er den Graphen erreicht hat, nicht nur, wenn er wahr wurde.
- Call Notes zu Entscheidungen. Meeting-Transkripte werden live als die Person gelesen und zusammengefasst: Notizen, Entscheidungen, wer was übernommen hat. Die Entscheidungen landen zeilenweise im Proposals-Tab der Person. Wer die Zusammenfassungen mit einem Kollegen teilt, zeigt ihm die Zusammenfassung, nie das Transkript.
- Belegte Fragen. Frag nach einem Kunden, einer Seite, einer Entscheidung. Die Antwort zitiert ihre Quellen, ist auf das beschnitten, was die Person sehen darf, und sagt “nicht gefunden” statt zu erfinden.
- Rückschreiben als du selbst. Am Ticket kommentieren, an die Wiki-Seite anhängen (nie ersetzen, damit Inline-Kommentare verankert bleiben), im Chat-Thread antworten, ein Arbeitselement anlegen. Jedes auf einer Karte freigegeben, jedes mit Beleg.
- Der Deal neben der Arbeit. CRM-Phase und Abschlussdatum neben der Engineering-Bewegung, die Frage, die kein einzelnes System beantwortet.
- Die Editor-Tür. Dasselbe Backend über MCP in Claude (Cowork, Desktop, der claude.ai-Connector), Codex und jeder MCP-fähigen Anwendung. Dieselbe Identität, dasselbe Gate, derselbe Audit-Trail.
etwas wird gesagt, oder etwas ändert sich in einem System
  -> eine Person sagt wahr, oder eine Person gibt frei
  -> es landet, zitiert, bei den Menschen, die es betrifft
  -> Aktionen gehen als die Person in die Systeme zurück, mit Beleg
"Helio fragt, ob die Bestellschnittstelle vor dem Go-live einen Massenimport kann, sie haben 1.200 Altpositionen"
Synthetischer Screenshot 2: das Freigabe-Gate. Ein Vorschlag wird als offen abgelegt und als Karte gepostet. Dieselbe Nachricht kann nie eine zweite Prüfung öffnen; eine Ablehnung ist selbst eine auditierte Entscheidung.
Synthetischer Screenshot 3: der Proposals-Tab, die Aktions-Inbox. Eine Zeile pro Aussage, ein Urteil pro Zeile. Eine Aussage ohne nachvollziehbare Beziehung wird abgewiesen, die Zeile bleibt offen. Ein Assistent darf in diese Liste vorschlagen und darf nicht annehmen.
Kontrollgarantien
Der Unterschied ist nicht das Modell. Es ist das, was die Schicht verweigert:
- Nur delegierte Berechtigungen. Kein Dienstkonto mit allem. Eine Person sieht, was sie ohnehin sehen würde, ein Assistent sieht, was seine Nutzerin sieht.
- Vorgeschlagene externe Aktionen brauchen vor der Ausführung eine Freigabe. Das gilt auch über MCP. Ein Assistent kann vorschlagen und kann nicht freigeben. Für das Teilen von Fakten gilt die separat dokumentierte Einzel- oder Dauerfreigabe.
- Nie zweimal gefragt. Dieselbe Nachricht öffnet nie eine zweite Prüfung, und dasselbe Signal aus einer zweiten Nachricht auch nicht; eine Ablehnung und eine Dublettenentscheidung sind auditierte Entscheidungen.
- Eine Prüfung bleibt offen, bis eine Person entscheidet. Eine verlorene Karte oder eine übersehene Nachricht schließt keine, und zwei Personen arbeiten nie dieselbe Zeile.
- Herkunft auf jedem Datensatz, die Erwähnung zitiert oder der Eintrag weggelassen. Grund, wortgleiche Textstelle, Autor, Link.
- Ringe bewerten Quellen, nie Menschen. Welchem System eine widersprüchliche Antwort folgen soll, wird gezeigt; keine Note, kein Abzeichen, kein Score sitzt je auf einem Kollegen.
- Personal- und personenbezogene Daten mehrstufig ausgeschlossen. Kommerzielle Konditionen und alles zur Beschäftigung reisen nie mit, auch bei aktivem Teilen. Meetings mit externen Teilnehmern werden abgelehnt. Transkripte werden nie gespeichert.
- Nur anhängender Audit-Trail, inklusive abgelehnter und deduplizierter Einträge. Das Zurücknehmen einer bestätigten Aktion ist Kompensation, nie Löschung. Jeder Fakt ist entfernbar.
- Lückentelemetrie ab Tag 1. Das Unternehmen sieht, welche Fragen die Schicht nicht beantworten konnte, pro Quelle, damit Wert pro System gemessen wird und nie pro Person.
- Datenresidenz präzise benannt. Compute, Speicher und die Inferenz des Sprachmodells in der EU, auf dem eigenen Cloud-Tenant des Unternehmens: OpenAI-Modelle in Azure AI Foundry, nur innerhalb der EU verarbeitet, jedes Modell mit seiner Bereitstellung benannt.
Leitplanke
Die Schicht schreibt das Produktivverhalten nie aus einer Sitzung heraus um. Ein gemeinsamer Fakt kommt durch ein menschliches Urteil oder eine begrenzte Dauerfreigabe herein, eine externe Aktion durch ihr Freigabe-Gate, und der Audit-Trail hält das Abgelehnte und das Deduplizierte neben dem Bestätigten. Wenn zwei Quellen sich widersprechen, sagt der Ring, welchem System zu folgen ist, und die Kette sagt, wo nachzusehen ist. Niemand bekommt standardmäßig ein Dossier, und jeder kann einen Sprung zum Datensatz machen, statt einem Kollegen zu schreiben.
Das Freigabemuster hinter diesem Gate, eine externe Aktion als offen abgelegt und der Tipp einer Person vor ihrer Ausführung, ist im Human-in-the-Loop Approval-Flow-Blueprint dokumentiert.
Fünf Fähigkeiten, die das belegt
- Berechtigungsbewusste Antworten über sechs Systeme ohne Dienstkonto.
- Ein Freigabe-Gate, das an jeder Tür hält, auch an der, die ein Assistent nutzt.
- Herkunft, die bis ins Radar, ins Briefing und in die Antwort überlebt.
- Rückschreiben in die Systeme als die Person, mit Beleg.
- Ein Wissensgraph, den Menschen über Urteile füllen und der sich auf dem Radar auszahlt.
Automatisches Teilen: der Wissensgraph auf dem Radar
Der Graph hält, was kein System hält. Eine Entscheidung aus einem Meeting, eine Einschränkung aus einem Telefonat, eine Korrektur aus einem Chat: nichts davon liegt in einem Ticket, auf einer Seite oder in einem Deal-Datensatz. Die Schicht macht daraus einen gezeichneten Fakt mit dem Datensatz, aus dem er stammt, teilt ihn automatisch mit genau dem Team, das er betrifft, und legt ihn innerhalb von Minuten auf dessen Radar, ohne dass jemand etwas verschicken muss. Das ist Informationen teilen, ohne dafür ein System zu bauen, und es ist der wichtigste Wert, den der Graph belegt hat.
Welche Vorschläge überhaupt ein Urteil brauchen und welche eine Regel ohne Klick tragen kann, ist die Routing-Frage aus den Freigaben für das Gedächtnis von KI-Agenten.
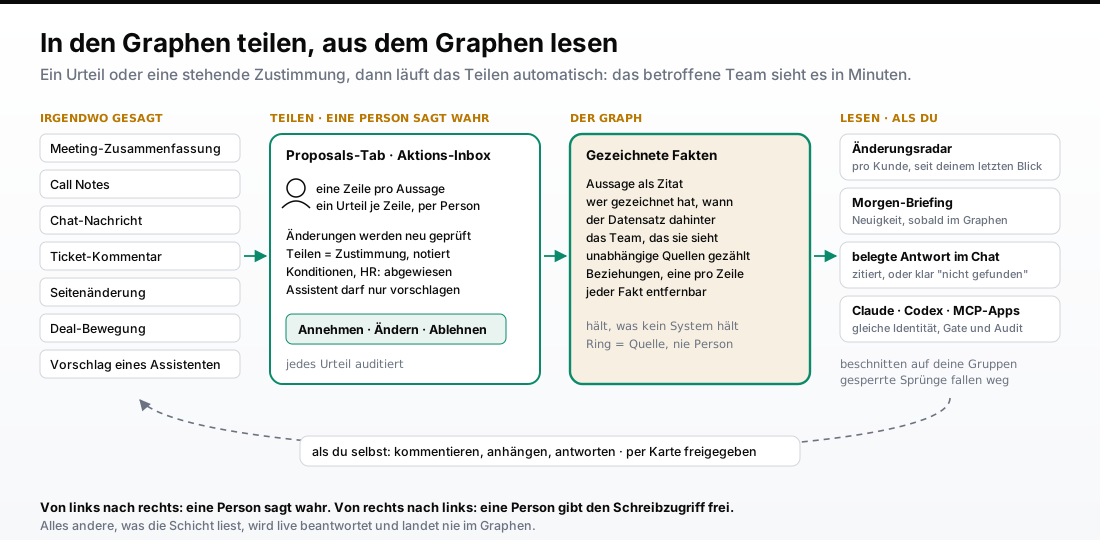
Von links nach rechts: eine Person sagt wahr. Von rechts nach links: eine Person gibt den Schreibzugriff frei. Alles andere, was die Schicht liest, wird live beantwortet und landet nie im Graphen.
Der jüngste Schritt legt den Graphen selbst auf das Radar, der Teil, den kein Digest hat:
- Der gezeichnete Fakt eines Kollegen erreicht das Radar des Teams innerhalb von Minuten. Wenn eine Person einen Fakt annimmt und mit einem Team teilt, sieht ihn jeder in diesem Team unter dem Kunden, den er nennt: die Aussage als zitierte Textstelle, wer gezeichnet hat, das Team, mit dem er geteilt ist. Die Zugehörigkeit wird als jede Person gelesen, damit der Fakt eines Teams seine Mitglieder erreicht und sonst niemanden, und die eigenen Fakten sind für dich keine Neuigkeit.
- Woher er kommt, in einer Zeile. Unter jedem Eintrag: der Datensatz, aus dem er stammt, wer ihn eingereicht hat, wer wann wahr dazu gesagt hat, wie viele unabhängige Quellen ihn stützen. Erst die zeichnende Person, dann das Meeting oder die Mail, der Link zur Zusammenfassung. Die volle Kette öffnet sich auf Tipp. Sie wird als “wo nachsehen” gezeigt, nie als “wie sehr glauben”.
- Der Test, der zählt. Jemand, der nicht im Meeting war, erfährt, was dort entschieden wurde, ohne jemanden zu fragen, der dabei war. Das ist der Satz, mit dem die Leute den Wert beschreiben.
- Eine Ticket-Zeile sagt, was sich bewegt hat, nicht, wo das Ticket steht. “Status To Do → In Progress”, aus der Änderungshistorie gelesen, ohne Mehrkosten. Eine Massenänderung ist eine Karte, die Zeilen dahinter auf Tipp.
- Unter jedem Kunden, woher seine Änderungen kamen. “Tickets 7 · Wiki 2 · Dein Postfach 1”, die Faltung sichtbar gemacht, und eine Zeile, die kein Digest eines einzelnen Systems drucken kann.
- Ein Weg in den Graphen. Ein Fakt erreicht den Graphen nur über das Urteil einer Person oder die stehende Zustimmung einer Person. Nichts, was die Schicht nur liest, landet je darin.
Was wir gemessen haben
| Punkt | Messwert |
|---|---|
| Quellen auf einem Radar gefaltet | 6 (Chat, Tickets, Wiki, CRM, Postfach, Meeting-Notizen) |
| Externe Aktionen ohne Autorisierung | 0, per Konstruktion, an jeder Tür |
| Zweimal geöffnete Prüfungen für ein Signal | 0, per Konstruktion |
Ehrlicher Stand
Im Produktivbetrieb auf dem eigenen Tenant des Kunden. Nutzung wird pro Tür aus den Audit-Ereignissen gemessen, nie aus Meinungen.
Architektur-Review anfragen
Diese Seite zeigt das Betriebsmodell und die Garantien. Die detaillierte Architektur dahinter bleibt mit Absicht von der Seite fern: Identitätsauflösung, Berechtigungsabbildung, Regeln für Autorität, Aktualität und Ablösung, die Schemata, Prompts und Tool-Orchestrierung, der Connector- und Deployment-Code.
Der Weg hinein ist ein Review des Schreibpfads der Agenten, die ihr schon betreibt, mit festem Stundenumfang: eure Routing-Regeln, das gemessene Verhältnis zwischen dem, was heute bei einem Menschen ankommt, und dem, was ankommen sollte, und die drei Regeln, die diese Zahl nach unten ziehen. Ihr bekommt das Review als Dokument, das ihr Security und Einkauf in die Hand geben könnt. Der Architektur-Rundgang folgt dem Review, sobald klar ist, wer fragt und wofür.
Das Review ist das KI-Pilot zu Production Audit; das 30-minütige Architekturgespräch ist der kostenfreie erste Schritt. Das vollständige Betriebsmodell, die zehn Garantien und ein Selbstcheck für euer Security-Review stehen auf der Seite Agenten-Kontrolle.
Einen Ablauf vom Kontext zur Aktion ausprobieren
Der Vergleich zur Palantir Foundry Alternative enthält einen eigenständigen Starter unter MIT-Lizenz: mit erfundenen Datensätzen, Python-SDK und einem Ablauf von der Freigabe bis zum Beleg. Er zeigt einen lokalen Workflow zum Prüfen und Erweitern.
Häufige Fragen
Was ist eine operative Kontextschicht, verglichen mit Enterprise Search oder einem Copilot?
Enterprise Search und Copilot-Assistenten holen Dokumente aus einem Silo und fassen sie zusammen. Eine operative Kontextschicht sitzt über den Systemen (Chat, Tickets, Wiki, CRM, Postfach, Meeting-Notizen), entscheidet, welcher Eintrag aktuell ist und für wen, zitiert die Textstelle, die ihn auf den Tisch gebracht hat, und macht daraus eine Aktion, die eine benannte Person freigibt. Sie beantwortet "Wie steht dieser Kunde gerade, und was tue ich damit", und das kann kein Digest eines einzelnen Systems.
Wie wird jede Antwort auf das beschnitten, was die fragende Person sehen darf?
Die Schicht hat keine eigenen Berechtigungen. Jeder Lesezugriff läuft delegiert, mit den eigenen Rechten der angemeldeten Person in jedem System, und die Gruppenzugehörigkeit wird zum Zeitpunkt der Frage aus den eigenen Verzeichnisgruppen des Unternehmens gelesen. Ein Treffer, den die Person nicht öffnen darf, fällt ohne Zähler weg, damit kein Meeting-Titel und kein Chat durch eine Zusammenfassung oder eine Herkunftskette sickert.
Was garantiert "freigegebene Aktionen" in der Praxis?
Ein vorgeschlagener Schreibzugriff wird als offen abgelegt und als Karte im Chat gepostet. Die vorgeschlagene externe Aktion wartet, bis eine Person Freigeben tippt. Separat können Fakten aus Meetings und deren Teilen durch eine begrenzte, am Fakt dokumentierte Dauerfreigabe autorisiert sein. Das gilt an jeder Tür, auch an der MCP-Tür, die ein Editor oder Assistent anbindet: Ein Assistent kann vorschlagen, er kann nicht freigeben. Dieselbe Nachricht öffnet nie eine zweite Prüfung, und dasselbe Signal aus einer zweiten Nachricht auch nicht.
Wie kommt ein Fakt in den Wissensgraphen, und wer hat dafür gezeichnet?
Nur über das Urteil einer Person oder die stehende Zustimmung einer Person. Die Prüfliste: eine Zeile pro Aussage, ein Urteil pro Zeile, durch die Person. Das Teilen: eine einmal erteilte Zustimmung für Entscheidungen aus den eigenen Meetings, auf jedem daraus entstehenden Fakt festgehalten. Nichts, was die Schicht nur liest, landet je im Graphen.
Welche Daten sind per Design ausgeschlossen?
Personal- und personenbezogene Daten sind mehrstufig ausgeschlossen, von der Quellenauswahl über das Schema bis zum Audit-Trail. Kommerzielle Konditionen (Tagessätze, Margen, Rabatte, Vertragswerte) und alles zur Beschäftigung einer Person reisen nie mit, auch wenn Teilen aktiv ist. Meetings mit externen Teilnehmern werden abgelehnt. Transkripte werden live gelesen und nie gespeichert, nur die Zusammenfassung.
Wo läuft das, und wie ist die Datenresidenz?
Compute, Speicher und die Inferenz des Sprachmodells laufen in der EU, auf dem eigenen Cloud-Tenant des Unternehmens. Die Modelle sind OpenAI-Modelle in Azure AI Foundry, so bereitgestellt, dass Prompts und Antworten nur innerhalb der EU verarbeitet werden. Das Review-Dokument nennt jedes Modell mit seiner Bereitstellung, weil ein Security-Review genau diese Frage stellt.
Was unterscheidet das von den Digests, die in den großen Suiten eingebaut sind?
Die fassen den Inhalt eines Systems zusammen und schicken ihn dir, pro Silo. Die Kontextschicht faltet sechs Quellen pro Kunde, zitiert die Erwähnung oder lässt den Eintrag weg, legt den gezeichneten Fakt eines Kollegen und die protokollierte Entscheidung mit ihrer Kette auf das Radar des Teams, lässt dich dort handeln, wo die Änderung liegt, als du selbst, und zeigt den Deal neben der Engineering-Arbeit dahinter.
Kann ich es aus Claude, Codex oder einer anderen MCP-fähigen Anwendung nutzen?
Ja. Die MCP-Tür stellt dasselbe kontrollierte Backend Claude (Cowork, Desktop und dem claude.ai-Connector), Codex und jeder MCP-fähigen Anwendung bereit. Die Identität der aufrufenden Person reist mit dem Aufruf, also wird jede Antwort auf diese Person beschnitten, ein Assistent kann in den Proposals-Tab vorschlagen und nicht annehmen, und jeder Aufruf landet im selben Audit-Trail wie der Chat-Tab.
Was passiert im Architektur-Review?
Ein Review des Schreibpfads der Agenten, die ihr schon betreibt, mit festem Stundenumfang: die Routing-Regeln, die entscheiden, was wahr werden darf, und das gemessene Verhältnis zwischen dem, was heute bei einem Menschen ankommt, und dem, was ankommen sollte. Die detaillierte Architektur hinter dieser Seite (Identitätsauflösung, Berechtigungsabbildung, Ablösungsregeln, Schemata und Prompts) wird in diesem Review geteilt, wenn klar ist, wer fragt und wofür.
Stack Stack
- Chat-Bot mit Freigabekarten und Tabs für das Änderungsradar und den Proposals-Tab
- Läuft auf dem eigenen Cloud-Tenant des Unternehmens in der EU
- Nur delegierter Zugriff: jeder Lese- und jeder Schreibzugriff als angemeldete Person, kein Dienstkonto
- Typisierte Datensätze mit Herkunft auf jedem Datensatz, nur anhängender Audit-Trail, Lückentelemetrie ab Tag 1
- MCP-Tür für Claude, Codex und MCP-fähige Anwendungen, mit derselben Identität, demselben Gate und demselben Audit-Trail
Ähnliches Projekt auf dem Tisch? Similar project on your desk?
Am schnellsten klärt das ein Gespräch. Termin direkt hier wählen: The fastest way to scope it is a conversation. Pick a slot right here:
Ihre Agenten antworten aus dem, was die Suche gerade findet, und oft ist das der Stand vom letzten Quartal. Ich baue die Kontextschicht, aus der sie antworten und handeln: einen temporalen Wissensgraphen, der jeden Fakt mit Quelle und Gültigkeitszeitraum hält, mit den Rechten der jeweiligen Person liest und nichts ohne Freigabe einer Person schreibt. Auf Ihrem eigenen Tenant, nach Stunden abgerechnet, Schritt für Schritt.